Primeiros passos com o dbt

- Published on
Ao começar meus estudos sobre Engenharia de dados, pesquisando vagas adequadas no mercado, uma das habilidades mais requisitadas que vejo constantemente é a experiência com uma ferramenta chamada dbt.
Então, para maximizar minhas chances de conseguir trabalho, decidi aprender o máximo possível sobre o dbt — o suficiente, pelo menos, para me sentir seguro ao falar sobre o assunto em termos gerais com outro profissional da área técnica durante uma entrevista, caso surgisse a oportunidade. Este artigo resume esse processo e o que aprendi. É claro que não se aprende um assunto apenas lendo a respeito; por isso, como de costume, apresentarei muitos exemplos práticos de código e casos de uso reais.
Para deixar claro, não tenho qualquer vínculo ou associação comercial com o dbt, o DuckDB ou seus criadores. O dbt Core é um software gratuito de código aberto, licenciado sob a Apache 2.0, e você pode executá-lo localmente sem uma conta dbt. O DuckDB também é de uso gratuito, sob a licença MIT.
O dbt oferece uma ampla gama de funcionalidades, mas, como esta é uma introdução ao assunto, vou me concentrar em explicar os conceitos básicos. Isso inclui o uso de modelos e fontes do dbt, bem como sua utilização para testar dados e criar documentação. Falaremos mais sobre tudo isso adiante.
Se você já trabalhou em algum projeto de análise de dados ou engenharia de dados de porte razoável, provavelmente acabou com uma pasta cheia de scripts SQL.
No início do projeto, tudo parece fácil de gerenciar. Você executa os scripts manualmente ou os agenda na ferramenta de orquestração que sua empresa utiliza. Tudo corre bem.
Então, o projeto cresce.
Uma coluna é renomeada em uma tabela e, de repente, um relatório ou painel dependente para de funcionar ou — o que é pior — sua tarefa noturna de ingestão de 10 milhões de registros falha, paralisando todo o sistema. A lista de problemas que um comando SQL aplicado incorretamente ou uma alteração na tabela podem causar a um sistema de banco de dados é assustadora. E quer saber? Isso acontece o tempo todo.
Parte do problema é que, tradicionalmente, o SQL tem sido tratado como uma coleção de scripts isolados, em vez de um projeto de software.
Se isso lhe parece muito familiar, a equipe por trás do dbt acredita ter uma solução.
O que é o dbt?
O dbt (data build tool) foi criado em meados da década de 2010 por um grupo hoje conhecido como dbt Labs. Ele evoluiu de um fluxo de trabalho interno de análise de dados para uma ferramenta de linha de comando (CLI) de código aberto amplamente utilizada — gratuita no plano para desenvolvedores — chamada dbt Core, coexistindo com uma versão paga e totalmente gerenciada chamada dbt Platform. Utilizarei a versão gratuita.
O dbt é usado para transformar dados já armazenados em um banco de dados, data warehouse ou data lakehouse. Ele realiza essa tarefa criando tabelas ou views com base em código SQL fornecido pelo usuário, mas também gerencia os seguintes aspectos:
- Testar a qualidade dos dados;
- Documentar conjuntos de dados e histórico dos dados;
- Reutilizar SQL por meio de macros;
- Gerenciar ambientes de desenvolvimento, teste e produção;
- Executar transformações via tarefas agendadas ou pipelines de CI/CD.
O dbt é amplamente utilizado por equipes que operam plataformas de banco de dados de nível empresarial, como Snowflake, BigQuery, Redshift e Databricks. No entanto, para os meus exemplos, utilizarei um banco de dados chamado DuckDB.
Por que as equipes de dados utilizam o dbt?
Principalmente porque ele é eficiente no que faz.
Imagine que você está criando uma plataforma de relatórios de vendas. Dados brutos de pedidos chegam ao seu data warehouse a cada hora, por exemplo. Você escreve um script SQL para limpar os dados, outro para calcular totais por cliente, mais um para consolidar os números de vendas diárias e outro para gerar dashboards executivos.
No início, o projeto conta com quatro ou cinco arquivos SQL, e é fácil gerenciá-los. Seis meses depois, já são cinquenta, e a ordem de execução deles deixa de ser óbvia.
- Qual script é executado em que ordem?
- O que quebra se alguém renomear uma coluna?
- Como você verifica se os dados ainda são válidos?
- Um novo desenvolvedor conseguiria entender o projeto sem abrir todos os arquivos SQL?
Frequentemente, as equipes de análise resolviam esses problemas utilizando convenções de nomenclatura, anotações manuais compartilhadas e um vasto conhecimento coletivo sobre os sistemas.
À medida que as organizações se tornavam mais orientadas a dados, os projetos de análise de dados passaram a se assemelhar cada vez mais a projetos de software. As equipes precisavam de controle de versão, testes automatizados, documentação e gerenciamento de dependências, pois escreviam milhares de linhas de código SQL.
Em vez de tratar scripts SQL como arquivos independentes, o dbt os trata como componentes de um projeto único, no qual cada transformação tem um propósito definido e todas as dependências são compreendidas.
Pré-requisitos
Estou utilizando o Windows como sistema operacional e tenho o Python 3.13 instalado. Tudo deve funcionar da mesma maneira se você estiver no Linux ou no macOS, mas é indispensável ter o Python instalado. Você também precisará de acesso a um banco de dados adequado para o dbt operar. A configuração para uso com o dbt varia de acordo com o banco de dados escolhido. Utilizarei o DuckDB como banco de dados e mostrarei como configurá-lo. Consulte a documentação do dbt caso esteja utilizando outro banco de dados.
Instalando o dbt
Agora que temos uma compreensão melhor do dbt, mostrarei no restante deste artigo como instalá-lo e, por meio de exemplos de código, demonstrarei os comandos mais comuns que você utilizará no seu dia a dia de trabalho.
A primeira medida a ser tomada é configurar um ambiente de desenvolvimento Python separado para manter nossos projetos isolados.
PS C:\Users\Réulison Silva> cd projects
PS C:\Users\Réulison Silva\projects> mkdir dbt-demo

    Directory: C:\Users\Réulison Silva\projects

Mode                 LastWriteTime         Length Name
----                 -------------         ------ ----
d-----        03/08/2026     16:21                dbt-demo

PS C:\Users\Réulison Silva\projects> cd dbt-demo
PS C:\Users\Réulison Silva\projects\dbt-demo> python3 -m venv .venv
Actual environment location may have moved due to redirects, links or junctions.
  Requested location: "C:\Users\Réulison Silva\projects\dbt-demo\.venv\Scripts\python3.exe"
  Actual location:    "D:\Users\Réulison Silva\projects\dbt-demo\.venv\Scripts\python3.exe"
PS C:\Users\Réulison Silva\projects\dbt-demo> .\.venv\Scripts\Activate.ps1
(.venv) PS C:\Users\Réulison Silva\projects\dbt-demo>
(.venv) PS C:\Users\Réulison Silva\projects\dbt-demo>
(.venv) PS C:\Users\Réulison Silva\projects\dbt-demo>
Você pode instalar o dbt usando um comando pip, como o mostrado abaixo. Para conectar o dbt a uma fonte de dados, utilizamos um recurso chamado adaptador. O dbt conta com diversos tipos de adaptadores — como BigQuery, AWS Redshift, Snowflake, entre outros. Nesta demonstração, utilizarei um banco de dados DuckDB local.
A maioria dos adaptadores precisa ser instalada separadamente do dbt-core; no entanto, para o DuckDB, o dbt oferece uma instalação em arquivo único.
(.venv) PS C:\Users\Réulison Silva\projects\dbt-demo> python3 -m pip install dbt-duckdb

Collecting dbt-duckdb
  Downloading dbt_duckdb-1.10.1-py3-none-any.whl.metadata (38 kB)
Collecting dbt-common<2,>=1 (from dbt-duckdb)
  Using cached dbt_common-1.38.0-py3-none-any.whl.metadata (5.0 kB)
Collecting dbt-adapters<2,>=1 (from dbt-duckdb)
  Using cached dbt_adapters-1.24.5-py3-none-any.whl.metadata (4.6 kB)
Collecting duckdb>=1.0.0 (from dbt-duckdb)
  Downloading duckdb-1.5.5-cp313-cp313-win_amd64.whl.metadata (4.2 kB)
Collecting dbt-core>=1.8.0 (from dbt-duckdb)
  Using cached dbt_core-1.12.0-py3-none-any.whl.metadata (4.5 kB)
Collecting agate<2.0,>=1.0 (from dbt-adapters<2,>=1->dbt-duckdb)
  Using cached agate-1.14.2-py3-none-any.whl.metadata (3.1 kB)
Collecting dbt-protos<2.0,>=1.0.291 (from dbt-adapters<2,>=1->dbt-duckdb)
  Using cached dbt_protos-1.0.541-py3-none-any.whl.metadata (859 bytes)
Collecting mashumaro<3.18,>=3.9 (from mashumaro[msgpack]<3.18,>=3.9->dbt-adapters<2,>=1->dbt-duckdb)
...
...
...

Using cached typing_inspection-0.4.2-py3-none-any.whl (14 kB)
Using cached tzdata-2026.3-py2.py3-none-any.whl (348 kB)
Using cached zipp-4.1.0-py3-none-any.whl (10 kB)
Installing collected packages: text-unidecode, pytz, pytimeparse, parsedatetime, leather, daff, zipp, urllib3, tzdata, typing-extensions, tabulate, sqlparse, sqlglot, six, rpds-py, rapidfuzz, pyyaml, python-slugify, python-dotenv, protobuf, pathspec, packaging, orderly-set, networkx, msgpack, more-itertools, MarkupSafe, isodate, idna, duckdb, dbt-extractor, dbt-core-experimental-parser, colorama, charset_normalizer, certifi, Babel, attrs, annotated-types, typing-inspection, requests, referencing, python-dateutil, pydantic-core, mashumaro, jinja2, importlib-metadata, deepdiff, dbt-protos, click, agate, snowplow-tracker, pydantic, jsonschema-specifications, jsonschema, metricflow, dbt-common, dbt-adapters, dbt-core, dbt-duckdb
Successfully installed Babel-2.18.0 MarkupSafe-3.0.3 agate-1.9.1 annotated-types-0.8.0 attrs-26.1.0 certifi-2026.7.22 charset_normalizer-3.4.9 click-8.4.2 colorama-0.4.6 daff-1.4.2 dbt-adapters-1.24.5 dbt-common-1.38.0 dbt-core-1.12.0 dbt-core-experimental-parser-2.0.0a5 dbt-duckdb-1.10.1 dbt-extractor-0.6.0 dbt-protos-1.0.541 deepdiff-8.6.2 duckdb-1.5.5 idna-3.18 importlib-metadata-9.0.0 isodate-0.7.2 jinja2-3.1.6 jsonschema-4.26.0 jsonschema-specifications-2025.9.1 leather-0.4.1 mashumaro-3.17 metricflow-0.211.0 more-itertools-10.8.0 msgpack-1.2.1 networkx-3.6.1 orderly-set-5.5.0 packaging-26.2 parsedatetime-2.6 pathspec-1.0.4 protobuf-6.33.6 pydantic-2.13.4 pydantic-core-2.46.4 python-dateutil-2.9.0.post0 python-dotenv-1.2.2 python-slugify-8.0.4 pytimeparse-1.1.8 pytz-2026.3.post1 pyyaml-6.0.3 rapidfuzz-3.14.5 referencing-0.37.0 requests-2.34.2 rpds-py-2026.6.3 six-1.17.0 snowplow-tracker-1.1.0 sqlglot-30.14.0 sqlparse-0.5.5 tabulate-0.10.0 text-unidecode-1.3 typing-extensions-4.16.0 typing-inspection-0.4.2 tzdata-2026.3 urllib3-2.7.0 zipp-4.1.0

[notice] A new release of pip is available: 26.1.2 -> 26.2
[notice] To update, run: python3.exe -m pip install --upgrade pip
(.venv) PS C:\Users\Réulison Silva\projects\dbt-demo>
Configurando um projeto dbt
O próximo passo é inicializar um projeto dbt. Fazemos isso utilizando o comando dbt init.
(.venv-core) PS C:\Users\Réulison Silva\projects\dbt-demo> dbt init
15:48:36  Running with dbt=1.12.0
Enter a name for your project (letters, digits, underscore): my-dbt-demo
my-dbt-demo is not a valid project name.
Enter a name for your project (letters, digits, underscore): my_dbt_demo
15:49:02  Setting up your profile.
Which database would you like to use?
[1] duckdb

(Don't see the one you want? https://docs.getdbt.com/docs/available-adapters)
Enter a number: 1
15:49:05  Profile my_dbt_demo written to C:\Users\Réulison Silva\.dbt\profiles.yml using target's sample configuration. Once updated, you'll be able to start developing with dbt.
15:49:05  Running dbt debug to validate the project...
15:49:05  dbt version: 1.12.0
15:49:05  python version: 3.13.14
15:49:05  python path: C:\Users\Réulison Silva\projects\dbt-demo\.venv-core\Scripts\python3.exe
15:49:05  os info: Windows-11-10.0.22621-SP0
15:49:05  Using profiles dir at C:\Users\Réulison Silva\.dbt
15:49:05  Using profiles.yml file at C:\Users\Réulison Silva\.dbt\profiles.yml
15:49:05  Using dbt_project.yml file at C:\Users\Réulison Silva\projects\dbt-demo\my_dbt_demo\dbt_project.yml
15:49:05  adapter type: duckdb
15:49:05  adapter version: 1.10.1
15:49:05  Configuration:
15:49:05    profiles.yml file [OK found and valid]
15:49:05    dbt_project.yml file [OK found and valid]
15:49:05  Required dependencies:
15:49:05   - git [OK found]
15:49:05  Connection:
15:49:05    database: dev
15:49:05    schema: main
15:49:05    path: dev.duckdb
15:49:05    config_options: None
15:49:05    extensions: None
15:49:05    settings: {}
15:49:05    external_root: .
15:49:05    use_credential_provider: None
15:49:05    attach: None
15:49:05    filesystems: None
15:49:05    remote: None
15:49:05    plugins: None
15:49:05    disable_transactions: False
15:49:05  Registered adapter: duckdb=1.10.1
15:49:05    Connection test: [OK connection ok]
15:49:05  All checks passed!
15:49:05  Your new dbt project "my_dbt_demo" was created!
Initialized new project in C:\Users\Réulison Silva\projects\dbt-demo\my_dbt_demo\my_dbt_demo
For more information on how to configure the profiles.yml file,
please consult the dbt documentation here:
  https://docs.getdbt.com/docs/configure-your-profile
One more thing:
Need help? Don't hesitate to reach out to us via GitHub issues or on Slack:
  https://community.getdbt.com/
Happy modeling!
A pasta models/example contém dois arquivos de modelo de exemplo e um arquivo de esquema. Falaremos mais sobre arquivos de modelo daqui a pouco, mas por enquanto você pode excluir com segurança toda a pasta example e seu conteúdo.
Um dos arquivos mais importantes que o processo de inicialização do dbt cria é o profiles.yml. Ele contém as propriedades de conexão do seu banco de dados, mas você não o verá na estrutura do seu projeto dbt. Em vez disso, no Windows, seu caminho completo é:
$HOME\.dbt\profiles.yml
Na minha configuração, o arquivo continha isto.
my_dbt_demo:
  outputs:
    dev:
      type: duckdb
      path: dev.duckdb
      threads: 1

    prod:
      type: duckdb
      path: prod.duckdb
      threads: 4

  target: dev
Agora podemos ver como o dbt espera que nosso banco de dados se chame e onde ele deve residir. Claro, você pode editar este arquivo e alterar esses detalhes se quiser. O caminho é relativo ao seu diretório HOME. Eu quero que meu arquivo de dados do duckDB esteja em:
C:\Users\Réulison Silva\projects\dbt-demo\data\my_dbt_demo
Então, atualizei meu arquivo profiles.yml para ficar assim:
my_dbt_demo:
  outputs:
    dev:
      type: duckdb
      path: "{{ env_var('USERPROFILE') }}/projects/dbt-demo/data/duckdb.dev"
      schema: raw
      threads: 1

    prod:
      type: duckdb
      path: "{{ env_var('USERPROFILE') }}/projects/dbt-demo/data/duckdb.prod"
      schema: raw
      threads: 4

  target: dev
Criando nosso banco de dados DuckDB
Agora podemos criar nosso banco de dados DuckDB. Para isso, precisamos instalar a CLI do DuckDB. Clique no link e siga as instruções adequadas ao seu ambiente.
Execute a CLI do DuckDB e forneça o nome de um arquivo adequado para armazenar seu banco de dados permanentemente. Você também pode executá-la sem parâmetros se não se importar em perder os dados ao sair. Digite o seguinte comando.
(.venv-core) PS C:\Users\Réulison Silva\projects\dbt-demo\my_dbt_demo> .\duckdb $HOME\projects\dbt-demo\my_dbt_demo\data\duckdb.dev
DuckDB v1.5.5 (Variegata)
Enter ".help" for usage hints.
duckdb D CREATE SCHEMA IF NOT EXISTS raw;
duckdb D
duckdb D CREATE OR REPLACE TABLE raw.orders (
             order_id       INTEGER,
             customer_name  VARCHAR,
             product_name   VARCHAR,
             order_date     DATE,
             quantity       INTEGER,
             unit_price     DECIMAL(10, 2),
             order_status   VARCHAR
         );
duckdb D INSERT INTO raw.orders VALUES
             (1,  'Alice',   'Laptop Stand', '2026-01-03', 1,  39.99, 'completed'),
             (2,  'Bob',     'USB-C Hub',    '2026-01-04', 2,  29.99, 'completed'),
             (3,  'Charlie', 'Webcam',       '2026-01-05', 1,  74.50, 'returned'),
             (4,  'Alice',   'Keyboard',     '2026-01-08', 1,  89.00, 'completed'),
             (5,  'Diana',   'Mouse',        '2026-01-10', 2,  24.99, 'completed'),
             (6,  'Bob',     'Monitor',      '2026-01-12', 1, 249.00, 'processing'),
             (7,  'Alice',   'USB-C Hub',    '2026-02-02', 1,  29.99, 'completed'),
             (8,  'Charlie', 'Keyboard',     '2026-02-06', 1,  89.00, 'completed'),
             (9,  'Diana',   'Webcam',       '2026-02-09', 2,  74.50, 'completed'),
             (10, 'Bob',     'Mouse',        '2026-02-14', 1,  24.99, 'cancelled'),
             (11, 'Alice',   'Monitor',      '2026-03-01', 1, 249.00, 'completed'),
             (12, 'Diana',   'Laptop Stand', '2026-03-05', 2,  39.99, 'completed');
duckdb D
duckdb D SHOW ALL TABLES;
┌──────────┬─────────┬─────────┬─────────────────────────────────────┬─────────────────────────────────────┬───────────┐
│ database │ schema  │  name   │            column_names             │            column_types             │ temporary │
│ varchar  │ varchar │ varchar │              varchar[]              │              varchar[]              │  boolean  │
├──────────┼─────────┼─────────┼─────────────────────────────────────┼─────────────────────────────────────┼───────────┤
│ duckdb   │ raw     │ orders  │ [order_id, customer_name,           │ [INTEGER, VARCHAR, VARCHAR, DATE,   │ false     │
│          │         │         │  product_name, order_date,          │  INTEGER, 'DECIMAL(10,2)', VARCHAR] │           │
│          │         │         │  quantity, unit_price,              │                                     │           │
│          │         │         │  order_status]                      │                                     │           │
└──────────┴─────────┴─────────┴─────────────────────────────────────┴─────────────────────────────────────┴───────────┘
duckdb D
duckdb D SELECT *
         FROM raw.orders
         ORDER BY order_id;
┌──────────┬───────────────┬──────────────┬────────────┬──────────┬───────────────┬──────────────┐
│ order_id │ customer_name │ product_name │ order_date │ quantity │  unit_price   │ order_status │
│  int32   │    varchar    │   varchar    │    date    │  int32   │ decimal(10,2) │   varchar    │
├──────────┼───────────────┼──────────────┼────────────┼──────────┼───────────────┼──────────────┤
│        1 │ Alice         │ Laptop Stand │ 2026-01-03 │        1 │         39.99 │ completed    │
│        2 │ Bob           │ USB-C Hub    │ 2026-01-04 │        2 │         29.99 │ completed    │
│        3 │ Charlie       │ Webcam       │ 2026-01-05 │        1 │         74.50 │ returned     │
│        4 │ Alice         │ Keyboard     │ 2026-01-08 │        1 │         89.00 │ completed    │
│        5 │ Diana         │ Mouse        │ 2026-01-10 │        2 │         24.99 │ completed    │
│        6 │ Bob           │ Monitor      │ 2026-01-12 │        1 │        249.00 │ processing   │
│        7 │ Alice         │ USB-C Hub    │ 2026-02-02 │        1 │         29.99 │ completed    │
│        8 │ Charlie       │ Keyboard     │ 2026-02-06 │        1 │         89.00 │ completed    │
│        9 │ Diana         │ Webcam       │ 2026-02-09 │        2 │         74.50 │ completed    │
│       10 │ Bob           │ Mouse        │ 2026-02-14 │        1 │         24.99 │ cancelled    │
│       11 │ Alice         │ Monitor      │ 2026-03-01 │        1 │        249.00 │ completed    │
│       12 │ Diana         │ Laptop Stand │ 2026-03-05 │        2 │         39.99 │ completed    │
└──────────┴───────────────┴──────────────┴────────────┴──────────┴───────────────┴──────────────┘
  12 rows                                                                              7 columns
duckdb D
Criando e executando um modelo dbt com uma fonte
Agora que temos dados em nosso banco de dados, podemos começar a usar o dbt. Dois dos conceitos mais importantes para compreender no dbt são os de modelos e fontes (sources).
Um modelo é simplesmente um arquivo contendo um trecho de SQL que o dbt utiliza para criar uma nova tabela ou view no seu banco de dados de destino.
Uma fonte é uma tabela ou view já existente no seu banco de dados que não foi criada pelo dbt — como, por exemplo, dados brutos carregados por uma aplicação ou ferramenta de ingestão. As fontes são a maneira pela qual os modelos fazem referência a tabelas existentes no seu banco de dados ou schema. Você define uma fonte usando um arquivo de configuração YAML. Como estamos trabalhando com uma tabela de pedidos (orders), chamaremos o nosso arquivo de orders.yml.
Para o nosso exemplo, vamos criar um modelo que gera uma tabela para armazenar pedidos concluídos. Esse modelo fará referência à nossa tabela de pedidos já existente no banco de dados; portanto, faz sentido criar um arquivo YAML de fonte para ela. O arquivo tem esta aparência:
# orders.yml

version: 2

sources:
  - name: raw
    schema: raw
    tables:
      - name: orders
E nosso arquivo SQL modelo tem esta aparência.
-- customer_orders_summary.sql

{{ config(materialized='table') }}

with completed_orders as (

    select
        order_id,
        customer_name,
        order_date,
        quantity,
        quantity * unit_price as order_value
    from {{ source('raw', 'orders') }}
    where lower(order_status) = 'completed'

)

select
    customer_name,
    count(*) as completed_order_count,
    sum(quantity) as total_units_purchased,
    round(sum(order_value), 2) as total_revenue,
    round(avg(order_value), 2) as average_order_value,
    min(order_date) as first_order_date,
    max(order_date) as most_recent_order_date
from completed_orders
group by customer_name
Crie tanto o arquivo SQL do modelo quanto o arquivo YAML da fonte (source) na pasta models do seu projeto dbt.
É provável que você perceba imediatamente a vantagem de usar uma fonte no arquivo do modelo. Como a cláusula FROM no SQL utiliza uma referência em vez do nome real da tabela, caso o nome da tabela de origem mude futuramente, você só precisará atualizar essa informação em um único lugar: o arquivo da fonte. Todos os comandos SQL que utilizam essa fonte continuarão funcionando sem alterações.
Muito bem, agora que esses arquivos foram criados, podemos executar a transformação do dbt. Para isso, utilize o comando dbt run.
(.venv-core) PS C:\Users\Réulison Silva\projects\dbt-demo\my_dbt_demo> dbt run
20:33:39  Running with dbt=1.12.0
20:33:40  Registered adapter: duckdb=1.10.1
20:33:40  Unable to do partial parsing because profile has changed
20:33:41  [WARNING]: Configuration paths exist in your dbt_project.yml file which do not apply to any resources.
There are 1 unused configuration paths:
- models.my_dbt_demo.example
20:33:41  Found 1 model, 1 source, 486 macros
20:33:41
20:33:41  Concurrency: 1 threads (target='dev')
20:33:41
20:33:41  1 of 1 START sql table model raw.customer_order_summary ........................ [RUN]
20:33:41  1 of 1 OK created sql table model raw.customer_order_summary ................... [OK in 0.11s]
20:33:41
20:33:41  Finished running 1 table model in 0 hours 0 minutes and 0.23 seconds (0.23s).
20:33:41
20:33:41  Completed successfully
20:33:41
20:33:41  Done. PASS=1 WARN=0 ERROR=0 SKIP=0 NO-OP=0 REUSED=0 TOTAL=1

(.venv-core) PS C:\Users\Réulison Silva\projects\dbt-demo\my_dbt_demo> .\duckdb $HOME\projects\dbt-demo\my_dbt_demo\data\duckdb.dev
DuckDB v1.5.5 (Variegata)
Enter ".help" for usage hints.
duckdb D show all tables;
┌──────────┬─────────┬────────────────────────┬─────────────────────────────┬──────────────────────────────┬───────────┐
│ database │ schema  │          name          │        column_names         │         column_types         │ temporary │
│ varchar  │ varchar │        varchar         │          varchar[]          │          varchar[]           │  boolean  │
├──────────┼─────────┼────────────────────────┼─────────────────────────────┼──────────────────────────────┼───────────┤
│ duckdb   │ raw     │ customer_order_summary │ [customer_name,             │ [VARCHAR, BIGINT, HUGEINT,   │ false     │
│          │         │                        │  completed_order_count,     │  'DECIMAL(38,2)', DOUBLE,    │           │
│          │         │                        │  total_units_purchased,     │  DATE, DATE]                 │           │
│          │         │                        │  total_revenue,             │                              │           │
│          │         │                        │  average_order_value,       │                              │           │
│          │         │                        │  first_order_date,          │                              │           │
│          │         │                        │  most_recent_order_date]    │                              │           │
├──────────┼─────────┼────────────────────────┼─────────────────────────────┼──────────────────────────────┼───────────┤
│ duckdb   │ raw     │ orders                 │ [order_id, customer_name,   │ [INTEGER, VARCHAR, VARCHAR,  │ false     │
│          │         │                        │  product_name, order_date,  │  DATE, INTEGER,              │           │
│          │         │                        │  quantity, unit_price,      │  'DECIMAL(10,2)', VARCHAR]   │           │
│          │         │                        │  order_status]              │                              │           │
└──────────┴─────────┴────────────────────────┴─────────────────────────────┴──────────────────────────────┴───────────┘

duckdb D select * from raw.customer_order_summary;
┌───────────────┬───────────────────────┬───┬─────────────────────┬──────────────────┬────────────────────────┐
│ customer_name │ completed_order_count │ … │ average_order_value │ first_order_date │ most_recent_order_date │
│    varchar    │         int64         │ … │       double        │       date       │          date          │
├───────────────┼───────────────────────┼───┼─────────────────────┼──────────────────┼────────────────────────┤
│ Charlie       │                     1 │ … │                89.0 │ 2026-02-06       │ 2026-02-06             │
│ Alice         │                     4 │ … │               102.0 │ 2026-01-03       │ 2026-03-01             │
│ Bob           │                     1 │ … │               59.98 │ 2026-01-04       │ 2026-01-04             │
│ Diana         │                     3 │ … │               92.99 │ 2026-01-10       │ 2026-03-05             │
└───────────────┴───────────────────────┴───┴─────────────────────┴──────────────────┴────────────────────────┘
O resultado é o esperado. Uma nova tabela de resumo é criada com os registros necessários. Isso é tudo o que direi sobre modelos e fontes. O que mostrei pode parecer um pouco trabalhoso para apenas uma tabela — e realmente é —, mas acredite: se você estiver lidando com dezenas ou centenas de tabelas e transformações, não se arrependerá do tempo investido na criação de modelos e fontes.
Usando o dbt para testar seus dados
Outra vantagem de usar o dbt é a capacidade de automatizar o ciclo de testes SQL. Os testes são definidos (em YAML) juntamente com seus modelos e fontes, podendo ser executados de forma independente ou sempre que o projeto for compilado. Você pode criar seus próprios testes SQL, mas o dbt também oferece quatro condições de teste nativas:
- unique
- not_null
- relationships
- accepted_values
Vou demonstrar dois desses testes para lhe dar uma ideia do que você pode fazer com eles.
Teste de não nulo (not_null)
Nosso teste será executado na coluna customer_name da tabela customer_order_summary. Como estamos testando uma tabela que o dbt está criando, adicionamos a configuração do teste em YAML a uma seção models no arquivo orders.yml. Ele agora está assim:
# orders.yml

version: 2

sources:
  - name: raw
    schema: raw
    tables:
      - name: orders

models:
  - name: customer_order_summary
    columns:
      - name: customer_name
        data_tests:
          - not_null
Como eu não tinha nenhum nome de cliente nulo na minha tabela de pedidos original, criei um para que possamos ver a aparência de um teste que falha.
duckdb D update raw.orders set customer_name = NULL where order_id = 1;
duckdb D select * from raw.orders;
┌──────────┬───────────────┬──────────────┬────────────┬──────────┬───────────────┬──────────────┐
│ order_id │ customer_name │ product_name │ order_date │ quantity │  unit_price   │ order_status │
│  int32   │    varchar    │   varchar    │    date    │  int32   │ decimal(10,2) │   varchar    │
├──────────┼───────────────┼──────────────┼────────────┼──────────┼───────────────┼──────────────┤
│        1 │ NULL          │ Laptop Stand │ 2026-01-03 │        1 │         39.99 │ completed    │
│        2 │ Bob           │ USB-C Hub    │ 2026-01-04 │        2 │         29.99 │ completed    │
│        3 │ Charlie       │ Webcam       │ 2026-01-05 │        1 │         74.50 │ returned     │
│        4 │ Alice         │ Keyboard     │ 2026-01-08 │        1 │         89.00 │ completed    │
│        5 │ Diana         │ Mouse        │ 2026-01-10 │        2 │         24.99 │ completed    │
│        6 │ Bob           │ Monitor      │ 2026-01-12 │        1 │        249.00 │ processing   │
│        7 │ Alice         │ USB-C Hub    │ 2026-02-02 │        1 │         29.99 │ completed    │
│        8 │ Charlie       │ Keyboard     │ 2026-02-06 │        1 │         89.00 │ completed    │
│        9 │ Diana         │ Webcam       │ 2026-02-09 │        2 │         74.50 │ completed    │
│       10 │ Bob           │ Mouse        │ 2026-02-14 │        1 │         24.99 │ cancelled    │
│       11 │ Alice         │ Monitor      │ 2026-03-01 │        1 │        249.00 │ completed    │
│       12 │ Diana         │ Laptop Stand │ 2026-03-05 │        2 │         39.99 │ completed    │
└──────────┴───────────────┴──────────────┴────────────┴──────────┴───────────────┴──────────────┘
  12 rows                                                                              7 columns
Agora, para executar nosso teste, podemos simplesmente digitar o comando dbt build desta forma; ele executa e valida as partes selecionadas de um projeto dbt na ordem de dependência.
(.venv-core) PS C:\Users\Réulison Silva\projects\dbt-demo\my_dbt_demo> dbt build
08:43:19  Running with dbt=1.12.0
08:43:20  Registered adapter: duckdb=1.10.1
08:43:20  [WARNING]: Configuration paths exist in your dbt_project.yml file which do not apply to any resources.
There are 1 unused configuration paths:
- models.my_dbt_demo.example
08:43:20  Found 1 model, 1 test, 1 source, 486 macros
08:43:20
08:43:20  Concurrency: 1 threads (target='dev')
08:43:20
08:43:20  1 of 2 START sql table model raw.customer_order_summary ........................ [RUN]
08:43:20  1 of 2 OK created sql table model raw.customer_order_summary ................... [OK in 0.14s]
08:43:20  2 of 2 START test not_null_customer_order_summary_customer_name ................ [RUN]
08:43:20  2 of 2 FAIL 1 not_null_customer_order_summary_customer_name .................... [FAIL 1 in 0.02s]
08:43:20
08:43:20  Finished running 1 table model, 1 test in 0 hours 0 minutes and 0.24 seconds (0.24s).
08:43:20
08:43:20  Completed with 1 error, 0 partial successes, and 0 warnings:
08:43:20
08:43:20  [ERROR]: in test not_null_customer_order_summary_customer_name (models\orders.yml)
08:43:20    Got 1 result, configured to fail if != 0
08:43:20
08:43:20    compiled code at target\compiled\my_dbt_demo\models\orders.yml\not_null_customer_order_summary_customer_name.sql
08:43:20
08:43:20  Done. PASS=1 WARN=0 ERROR=1 SKIP=0 NO-OP=0 REUSED=0 TOTAL=2
O problema é detectado e relatado. O dbt não exclui nem reverte um modelo quando um teste de dados subsequente a ele falha. No entanto, modelos que dependem do modelo testado (que ficam depois no fluxo de dados) são normalmente ignorados durante a execução da build. Se você quiser executar o teste sem recriar tabelas, etc., basta usar o comando dbt test.
Teste de valores aceitos (accepted_values)
Este teste faz exatamente o que o nome sugere. Ele permite verificar se uma coluna contém apenas valores específicos. Se observarmos nossa tabela de pedidos (orders), veremos que a coluna order_status deve conter apenas os valores: completed (concluído), processing (em processamento), returned (devolvido) ou cancelled (cancelado). Então, vamos atualizar a tabela e alterar um dos valores para algo diferente.
duckdb D select * from raw.orders where order_id = 10;
┌──────────┬───────────────┬──────────────┬────────────┬──────────┬───────────────┬──────────────┐
│ order_id │ customer_name │ product_name │ order_date │ quantity │  unit_price   │ order_status │
│  int32   │    varchar    │   varchar    │    date    │  int32   │ decimal(10,2) │   varchar    │
├──────────┼───────────────┼──────────────┼────────────┼──────────┼───────────────┼──────────────┤
│       10 │ Bob           │ Mouse        │ 2026-02-14 │        1 │         24.99 │ cancelled    │
└──────────┴───────────────┴──────────────┴────────────┴──────────┴───────────────┴──────────────┘
duckdb D update raw.orders set order_status = 'invalid' where order_id = 10;
duckdb D select * from raw.orders where order_id = 10;
┌──────────┬───────────────┬──────────────┬────────────┬──────────┬───────────────┬──────────────┐
│ order_id │ customer_name │ product_name │ order_date │ quantity │  unit_price   │ order_status │
│  int32   │    varchar    │   varchar    │    date    │  int32   │ decimal(10,2) │   varchar    │
├──────────┼───────────────┼──────────────┼────────────┼──────────┼───────────────┼──────────────┤
│       10 │ Bob           │ Mouse        │ 2026-02-14 │        1 │         24.99 │ invalid      │
└──────────┴───────────────┴──────────────┴────────────┴──────────┴───────────────┴──────────────┘
Como estamos testando uma tabela de origem, devemos incluir a configuração do teste em YAML na seção sources do nosso arquivo YAML. Você pode manter ou remover o teste null original, se quiser; eu decidi mantê-lo.
# orders.yml

version: 2

sources:
  - name: raw
    schema: raw
    tables:
      - name: orders
        columns:
          - name: order_status
            data_tests:
              - accepted_values:
                  arguments:
                    values:
                      - completed
                      - processing
                      - returned
                      - cancelled

models:
  - name: customer_order_summary
    columns:
      - name: customer_name
        data_tests:
          - not_null
Estamos executando o teste em uma tabela existente, então não precisamos executar o comando de build. Podemos simplesmente usar o dbt test.
(.venv-core) PS C:\Users\Réulison Silva\projects\dbt-demo\my_dbt_demo> dbt test
09:08:04  Running with dbt=1.12.0
09:08:04  Registered adapter: duckdb=1.10.1
09:08:04  [WARNING]: Configuration paths exist in your dbt_project.yml file which do not apply to any resources.
There are 1 unused configuration paths:
- models.my_dbt_demo.example
09:08:04  Found 1 model, 2 data tests, 1 source, 486 macros
09:08:04
09:08:04  Concurrency: 1 threads (target='dev')
09:08:04
09:08:04  1 of 2 START test not_null_customer_order_summary_customer_name ................ [RUN]
09:08:04  1 of 2 FAIL 1 not_null_customer_order_summary_customer_name .................... [FAIL 1 in 0.03s]
09:08:04  2 of 2 START test source_accepted_values_raw_orders_order_status__completed__processing__returned__cancelled  [RUN]
09:08:04  2 of 2 FAIL 1 source_accepted_values_raw_orders_order_status__completed__processing__returned__cancelled  [FAIL 1 in 0.02s]
09:08:04
09:08:04  Finished running 2 data tests in 0 hours 0 minutes and 0.11 seconds (0.11s).
09:08:04
09:08:04  Completed with 2 errors, 0 partial successes, and 0 warnings:
09:08:04
09:08:04  [ERROR]: in test not_null_customer_order_summary_customer_name (models\orders.yml)
09:08:04    Got 1 result, configured to fail if != 0
09:08:04
09:08:04    compiled code at target\compiled\my_dbt_demo\models\orders.yml\not_null_customer_order_summary_customer_name.sql
09:08:04
09:08:04  [ERROR]: in test source_accepted_values_raw_orders_order_status__completed__processing__returned__cancelled (models\orders.yml)
09:08:04    Got 1 result, configured to fail if != 0
09:08:04
09:08:04    compiled code at target\compiled\my_dbt_demo\models\orders.yml\source_accepted_values_raw_ord_0932c13ab9fb3a73a9e3e3c87c81af50.sql
09:08:04
09:08:04  Done. PASS=0 WARN=0 ERROR=2 SKIP=0 NO-OP=0 REUSED=0 TOTAL=2
(.venv-core) PS C:\Users\Réulison Silva\projects\dbt-demo\my_dbt_demo>
Os outros dois tipos de teste integrados são igualmente fáceis de configurar e executar, então vou parar por aqui.
Usando o dbt para documentar seu sistema
O último tópico introdutório sobre o dbt que abordaremos é, possivelmente, um de seus melhores recursos. A maioria das documentações começa com boas intenções, mas acaba ficando desatualizada silenciosamente. O dbt adota uma abordagem diferente em relação à documentação.
Como seus modelos, testes e metadados residem junto ao seu código SQL, o dbt consegue gerar a documentação do projeto automaticamente. Mais importante ainda: ele cria um gráfico visual de linhagem que mostra exatamente como os modelos dependem uns dos outros.
Isso é extremamente valioso quando alguém novo entra no projeto, pois a pessoa não precisa fazer engenharia reversa em centenas de arquivos SQL. Ela consegue visualizar todo o pipeline de transformação quase imediatamente.
É um daqueles recursos que não parecem muito empolgantes até que você precise assumir o projeto de análise de outra pessoa.
Logo de cara, o dbt já gera uma documentação automatizada para você, mas é aquele tipo de recurso em que quanto mais esforço você dedica, melhor é o resultado obtido. Sem realizar nenhuma configuração adicional no projeto, esta é a documentação básica que você obtém. Utilizamos o comando dbt docs generate para criar essa documentação.
(.venv-core) PS C:\Users\Réulison Silva\projects\dbt-demo\my_dbt_demo> dbt docs generate

09:21:19  Running with dbt=1.12.0
09:21:19  Registered adapter: duckdb=1.10.1
09:21:19  [WARNING]: Configuration paths exist in your dbt_project.yml file which do not apply to any resources.
There are 1 unused configuration paths:
- models.my_dbt_demo.example
09:21:19  Found 1 model, 2 data tests, 1 source, 486 macros
09:21:19
09:21:19  Concurrency: 1 threads (target='dev')
09:21:19
09:21:19  Building catalog
09:21:19  Catalog written to C:\Users\Réulison Silva\projects\dbt-demo\my_dbt_demo\target\catalog.json
Agora que geramos a documentação, podemos visualizá-la em um navegador web usando o comando dbt docs serve.
(.venv-core) PS C:\Users\Réulison Silva\projects\dbt-demo\my_dbt_demo> dbt docs serve
09:24:48  Running with dbt=1.12.0
Serving docs at 8080
To access from your browser, navigate to: http://localhost:8080

Press Ctrl+C to exit.
127.0.0.1 - - [04/Aug/2026 10:24:48] "GET / HTTP/1.1" 200 -
127.0.0.1 - - [04/Aug/2026 10:24:48] "GET /manifest.json?cb=1785835488811 HTTP/1.1" 200 -
127.0.0.1 - - [04/Aug/2026 10:24:48] "GET /catalog.json?cb=1785835488811 HTTP/1.1" 200 -
127.0.0.1 - - [04/Aug/2026 10:24:49] code 404, message File not found
127.0.0.1 - - [04/Aug/2026 10:24:49] "GET /%7B%7B%20getIcon(item.type,%20'on')%20%7D%7D HTTP/1.1" 404 -
127.0.0.1 - - [04/Aug/2026 10:24:49] code 404, message File not found
127.0.0.1 - - [04/Aug/2026 10:24:49] "GET /%7B%7B%20getIcon(item.type,%20'off')%20%7D%7D HTTP/1.1" 404 -
Você deverá ver uma janela do navegador aberta, semelhante a esta:
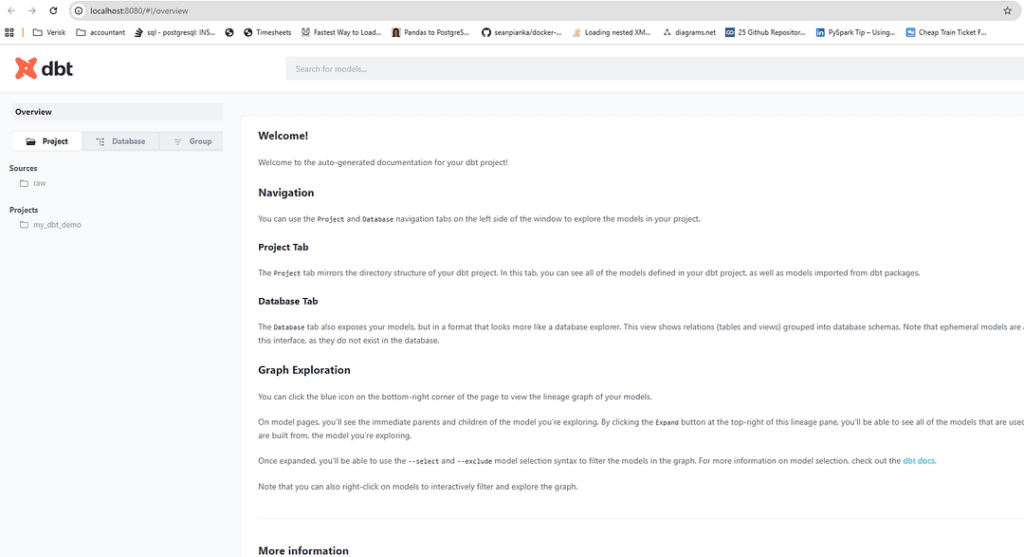
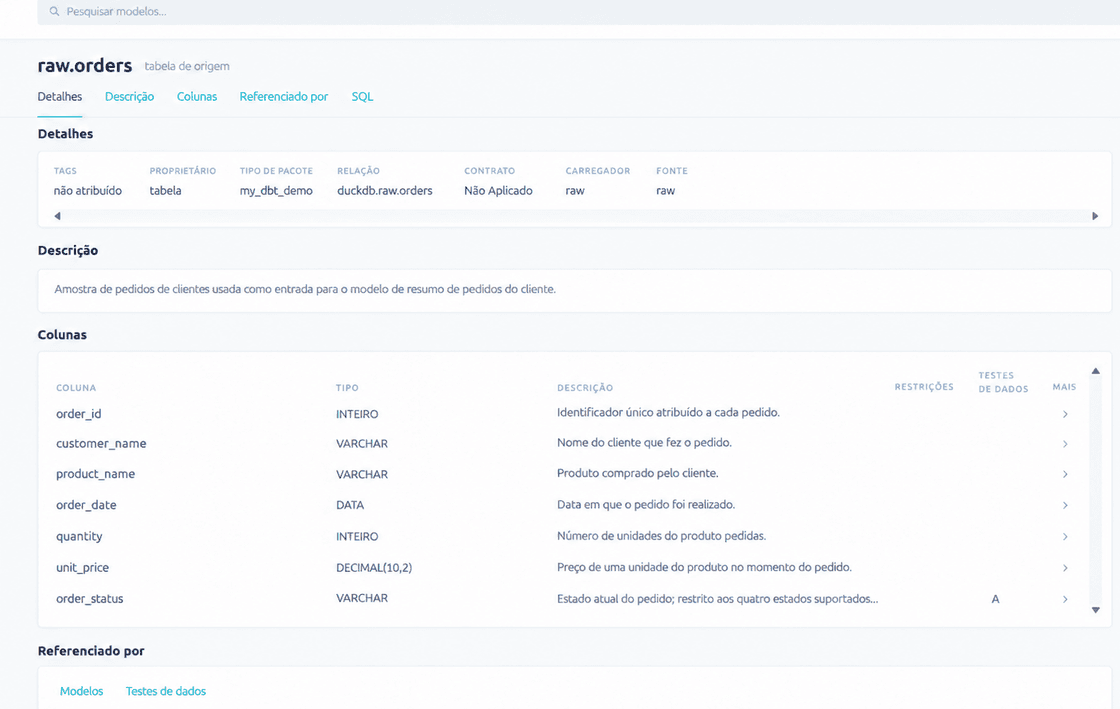
Como mencionei, é algo bem básico, mas ainda assim útil. Para ver o verdadeiro potencial, você precisa adicionar seu próprio texto de documentação — no formato YAML — ao arquivo orders.yml. Aqui está um exemplo.
version: 2

sources:
  - name: raw
    description: "Dados de demonstração brutos criados diretamente no DuckDB antes de as transformações do dbt serem executadas."
    schema: raw
    tables:
      - name: orders
        description: "Pedidos de clientes de exemplo usados como entrada para o modelo de resumo de pedidos de clientes."
        columns:
          - name: order_id
            description: "Identificador exclusivo atribuído a cada pedido."

          - name: customer_name
            description: "Nome do cliente que fez o pedido."

          - name: product_name
            description: "Produto adquirido pelo cliente."

          - name: order_date
            description: "Data em que o pedido foi feito."

          - name: quantity
            description: "Número de unidades do produto pedidas."

          - name: unit_price
            description: "Preço de uma unidade do produto no momento do pedido."

          - name: order_status
            description: "Estado atual do pedido; restrito aos quatro valores de status suportados."
            data_tests:
              - accepted_values:
                  arguments:
                    values:
                      - completed
                      - processing
                      - returned
                      - cancelled

models:
  - name: customer_order_summary
    description: >
      Uma tabela criada pelo dbt contendo uma linha por cliente. Ela inclui apenas pedidos concluídos e
      resume a contagem de pedidos, as unidades compradas, a receita e as datas dos pedidos.
    columns:
      - name: customer_name
        description: "Cliente representado pela linha de resumo."
        data_tests:
          - not_null

      - name: completed_order_count
        description: "Número de pedidos concluídos feitos pelo cliente."

      - name: total_units_purchased
        description: "Número total de unidades em todos os pedidos concluídos do cliente."

      - name: total_revenue
        description: "Valor total dos pedidos concluídos do cliente."

      - name: average_order_value
        description: "Valor médio dos pedidos concluídos do cliente."

      - name: first_order_date
        description: "Data do pedido concluído mais antigo do cliente."

      - name: most_recent_order_date
        description: "Data do pedido concluído mais recente do cliente."
Agora, ao executarmos os dois comandos de documentação do dbt, obtemos uma saída muito mais rica, como esta.
Próximos passos
O dbt é um ecossistema amplo e, como expliquei, meu objetivo foi abordar apenas alguns fundamentos do seu funcionamento. No momento, estou satisfeito com o conhecimento que adquiri sobre o uso do dbt. Se você quiser avançar, pode ser interessante aprofundar-se nos seguintes tópicos, que complementam o que apresentei aqui:
- Modelos incrementais: Processam apenas registros novos ou alterados, em vez de reconstruir uma tabela inteira a cada execução.
- Jinja: Uma linguagem de templating que permite adicionar variáveis, condições, loops e funções reutilizáveis ao SQL.
- Macros: Trechos reutilizáveis de lógica Jinja e SQL que podem receber parâmetros e gerar código SQL.
- Snapshots: Registram as alterações nos dados de origem ao longo do tempo, permitindo preservar seus valores históricos.
- Pacotes reutilizáveis: Permitem utilizar modelos, macros e testes criados em outros projetos dbt, em vez de desenvolver tudo do zero.
Então, gostou do artigo? Pode ser bem básico, mas acredito que pode ajudar muita gente que está começando no dbt, assim como eu.
Fique ligado
Seja um Expert em Growth
Receba insights práticos sobre marketing, dados, performance e tecnologia direto no seu email.