Análise de Atendimento Hospitalar com PySpark

- Published on
Este artigo é baseado no projeto de código aberto atendimento-hospitalar-pyspark, disponível no GitHub. É um projeto de estudo, mas as técnicas aqui demonstradas podem ter aplicabilidade real em hospitais e clínicas que enfrentam problemas de fila e ociosidade.
Introdução: por que analisar tempos de espera?
Todo mundo que já precisou de atendimento médico sabe como é frustrante esperar horas na fila. Mas o que talvez você não saiba é que essa espera não é só um problema para o paciente — é um problema financeiro gigantesco para o hospital.
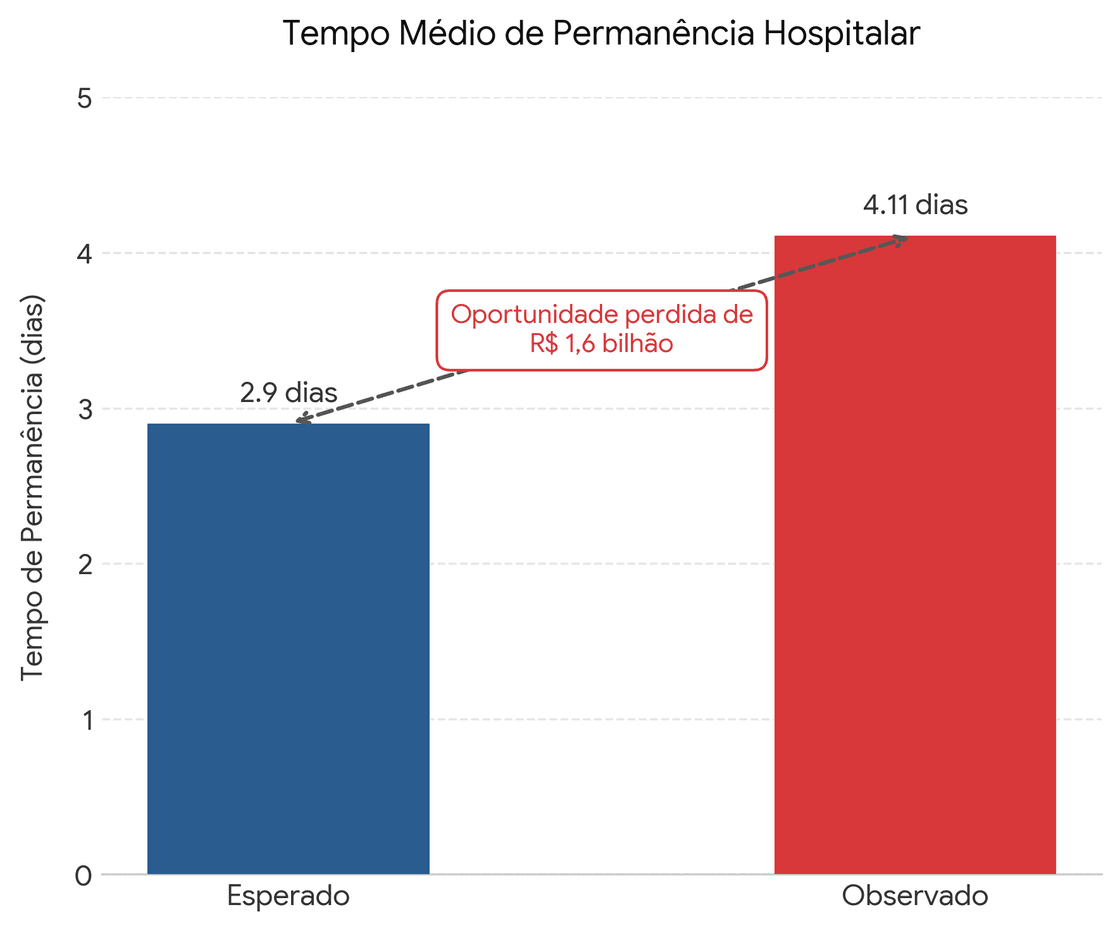
Um estudo publicado no Jornal Brasileiro de Economia da Saúde revelou que ineficiências na gestão hospitalar podem ter representado até R 1,6 bilhão no período analisado.
A extensão das internações impacta diretamente a rotatividade de leitos e a capacidade de geração de receita, além de pressionar custos operacionais.
Outro fator relevante é a logística de alta hospitalar. Cerca de 30,69% das altas ocorreram fora do horário considerado adequado, gerando impacto adicional estimado em R 2 bi](https://healthcare.grupomidia.com/ineficiencia-hospitalar-pode-gerar-perdas-de-r-2-bi/ "Ineficiência hospitalar pode gerar perdas de R$ 2 bi").
E isso sem falar no impacto clínico: quase 70 estudos mostram que a permanência prolongada em departamentos de emergência está associada a riscos elevados à saúde, atrasos no tratamento e aumento da probabilidade de morte.
No Brasil, a situação das filas do SUS é ainda mais dramática. Segundo reportagem do jornal O Globo de março de 2025, o tempo médio de espera para consultas no SUS atingiu um recorde histórico em 2024, com média de 57 dias — e pacientes aguardam até 634 dias por cirurgias eletivas. Para se ter uma ideia da escalada, em 2019 a média geral era de 31 dias; saltou para 51 dias em 2022 e chegou a 52 dias em 2023.
Mas não é só no setor público. Nos Estados Unidos, um estudo publicado na Annals of Emergency Medicine mostrou que o custo diário por paciente que fica "boarding" (esperando por um leito de internação) na emergência é de U 993 para clientes que já estão internados.
Esses números deixam claro: tempo de espera é dinheiro. E é exatamente isso que o projeto que vamos explorar neste artigo se propõe a investigar.
O que é PySpark e por que usá-lo?
A definição direta
PySpark é a API oficial do Apache Spark para Python. Se você já usou pandas para analisar dados, pode pensar no PySpark como um "pandas turbinado" — capaz de processar volumes de dados muito maiores, distribuindo o trabalho entre várias máquinas (ou núcleos de CPU). O Apache Spark, por sua vez, é um engine unificado de análise para processamento de dados em larga escala, com APIs de alto nível em Scala, Java, Python e R.
Quando usar PySpark em vez de pandas?
A regra prática é simples:
- Pandas: dados que cabem na memória RAM de uma máquina (até alguns GB).
- PySpark: dados que não cabem na memória, ou que você quer processar de forma distribuída e escalável.
No caso do nosso projeto, o dataset tem cerca de 30 mil linhas — um volume que o pandas daria conta tranquilamente. Mas o objetivo é estudar PySpark, então a escolha faz todo sentido: você treina com dados pequenos e depois aplica as mesmas técnicas em dados de produção (milhões de atendimentos) sem mudar o código.
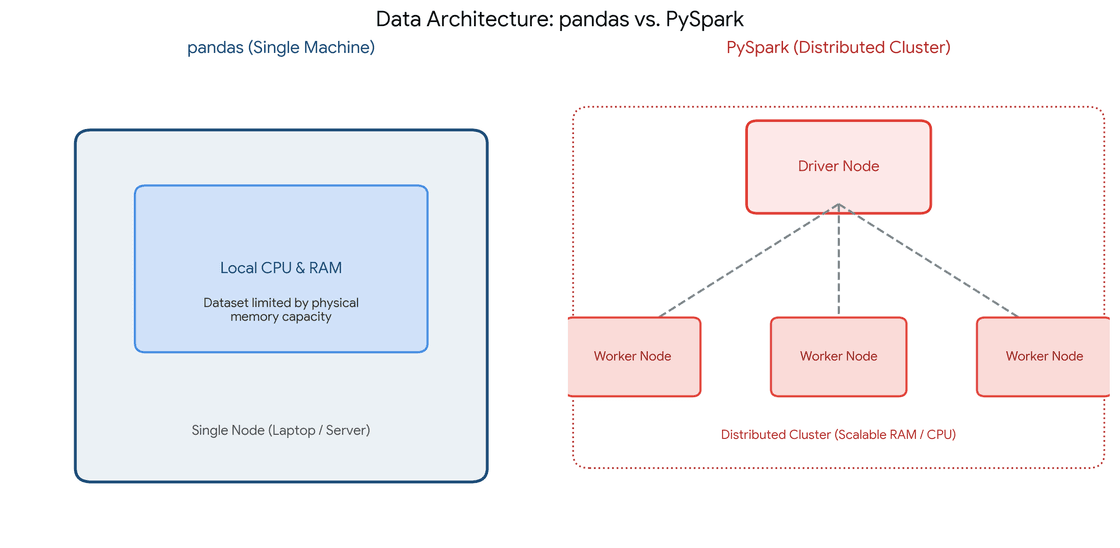
Arquitetura de Processamento: pandas vs. PySpark
pandas (Máquina Única)
- Ambiente: Executa localmente em um único computador ou notebook.
- Limitação: O volume de dados fica estritamente restrito à memória RAM disponível no seu hardware.
- Fluxo: Monolítico e sequencial (utiliza essencialmente um único núcleo da CPU por padrão).
PySpark (Processamento Distribuído)
- Ambiente: Funciona em um cluster de computadores interligados em rede.
- Escalabilidade: Divide os dados e as tarefas em múltiplos nós (computadores/servidores). Um nó principal (Driver) coordena o trabalho que é processado em paralelo pelos nós de execução (Workers).
- Fluxo: Processamento massivo e distribuído na memória de várias máquinas simultaneamente.
Como configurar o ambiente PySpark
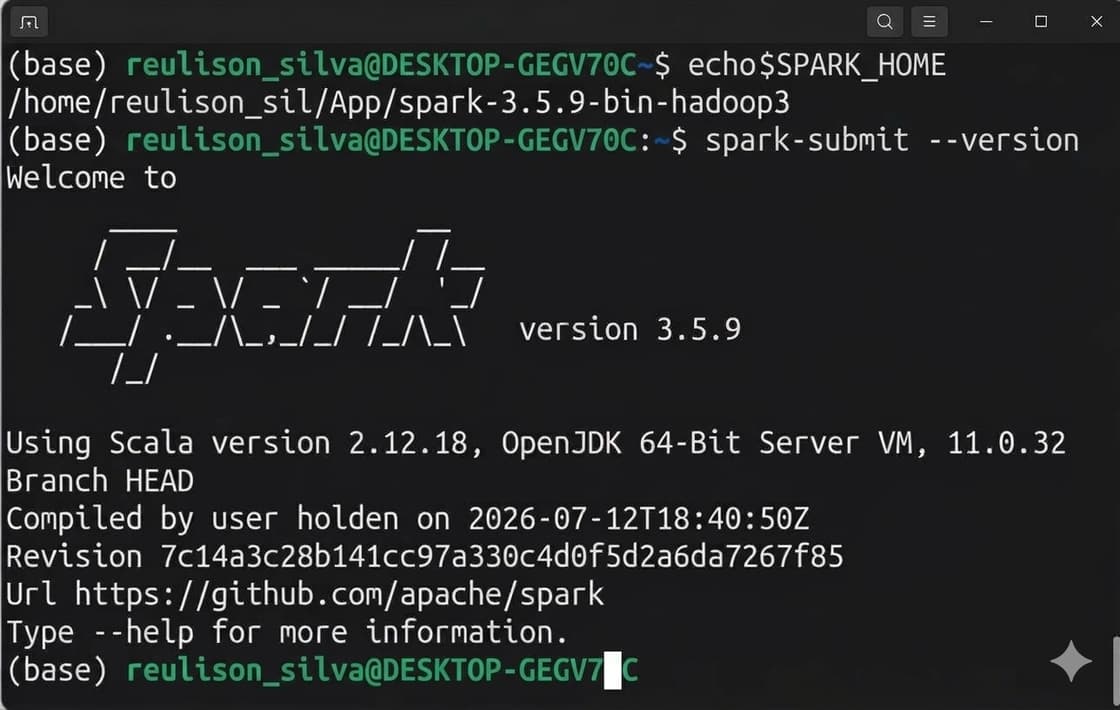
A configuração do PySpark tem três pré-requisitos principais:
Java (JDK/JRE): O Spark roda sobre a JVM (Java Virtual Machine). Você precisa do Java 8, 11 ou 17. No notebook do projeto, eu usei o JRE 8 por uma questão de compatibilidade no Windows (JDK 17 apresentou erro
IllegalAccessErrorpor causa do sistema de módulos).PySpark: Instale via pip:
pip install pyspark
Variáveis de ambiente: É aqui que muita gente tropeça. Você precisa configurar:
JAVA_HOME: caminho da instalação do JavaSPARK_HOME: caminho da instalação do PySpark (geralmente dentro do site-packages)PYSPARK_PYTHON: caminho do executável Python que o Spark vai usar
No notebook, fiz isso logo nas primeiras linhas:
import os
os.environ['JAVA_HOME'] = r'C:\Program Files\Java\jre1.8.0_503'
os.environ['PATH'] = os.path.join(os.environ['JAVA_HOME'], 'bin') + ';' + os.environ['PATH']
os.environ['SPARK_HOME'] = r'...\Lib\site-packages\pyspark'
os.environ['PYSPARK_PYTHON'] = r'...\python.exe'
Dica: No Windows, evite instalar o projeto em caminhos com caracteres acentuados ou espaços. O launcher do Spark pode falhar ao montar o classpath do Java. Eu contornei isso usando caminhos curtos do Windows (ex.: RULISO~1 em vez de Réulison Silva).
O projeto: análise de atendimento hospitalar
Visão geral
O projeto atendimento-hospitalar-pyspark é uma análise exploratória de dados (EDA) de atendimentos hospitalares, com foco em tempo de espera e dimensionamento de equipe médica. Ele reproduz, usando PySpark, uma análise que originalmente seria feita em pandas puro.
O dataset principal vem do Kaggle: Hospital Patient Data, com cerca de 30 mil registros de atendimentos contendo informações como receitas, custos, tipo de médico, classe financeira do paciente e — o mais importante — os horários de entrada, pós-consulta e conclusão do atendimento.
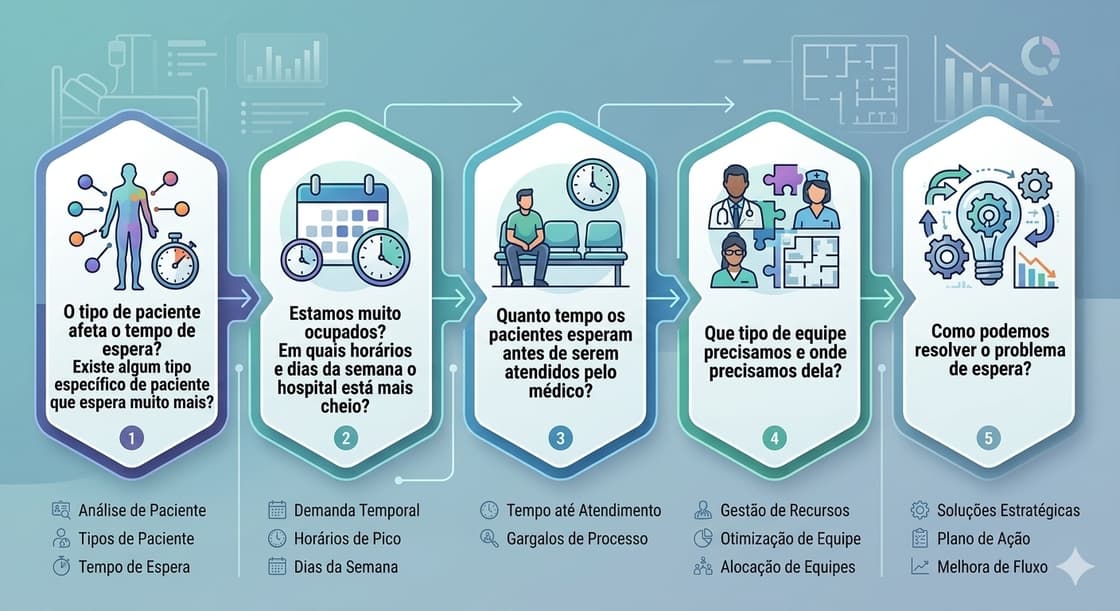
As perguntas que o projeto responde
O notebook estrutura a análise em torno de perguntas de negócio bem concretas:
- O tipo de paciente afeta o tempo de espera? Existe algum tipo específico de paciente que espera muito mais?
- Estamos muito ocupados? Em quais horários e dias da semana o hospital está mais cheio?
- Quanto tempo os pacientes esperam antes de serem atendidos pelo médico?
- Que tipo de equipe precisamos e onde precisamos dela?
- Como podemos resolver o problema de espera?
Estrutura do código: passo a passo
Ingestão de dados
O download do dataset é feito via kagglehub:
import kagglehub
path = kagglehub.dataset_download('abdulqaderasiirii/hospital-patient-data')
Depois, os dados são carregados com pandas e convertidos para um DataFrame PySpark. Essa ponte pandas → PySpark é comum quando o dataset não é gigante, mas você quer aproveitar a API do Spark para as transformações.
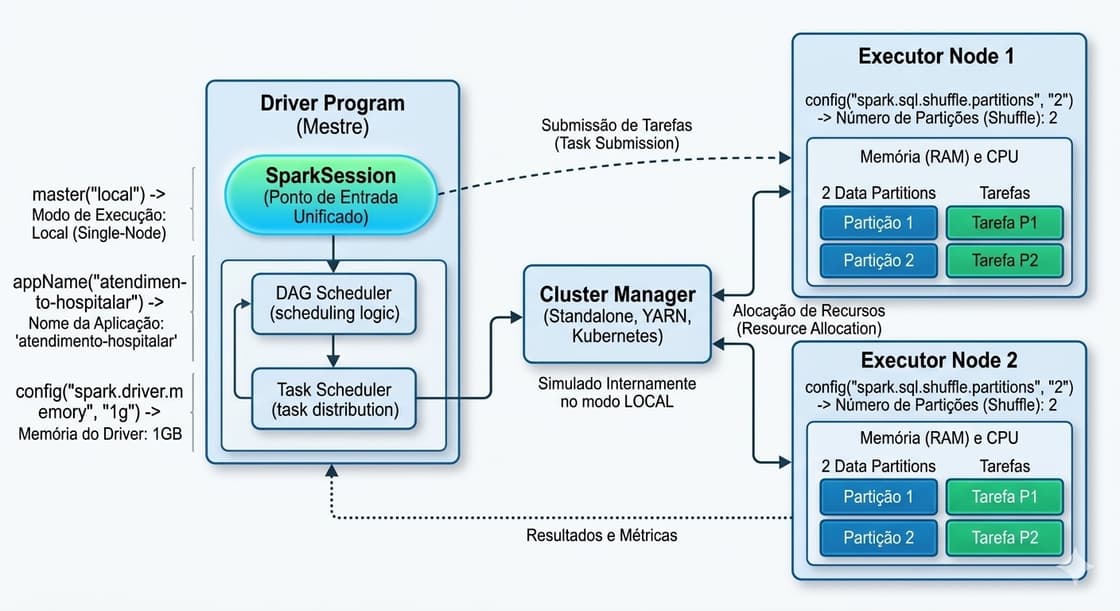
Criação da SparkSession
A SparkSession é o ponto de entrada para programar com Spark usando a API de DataFrame e Dataset. Com ela, você pode criar DataFrames, registrar tabelas, executar SQL, cachear tabelas e ler arquivos Parquet.
spark = SparkSession.builder \
    .master("local") \
    .appName("atendimento-hospitalar") \
    .config("spark.sql.shuffle.partitions", "2") \
    .config("spark.driver.memory", "1g") \
    .getOrCreate()
Vamos detalhar cada parte:
.master("local"): Define que o Spark vai rodar em modo local (single-node). Em produção, você usariayarn(Hadoop) ouspark://...(cluster standalone)..appName("atendimento-hospitalar"): Nome da aplicação, aparece na UI do Spark.- .
config("spark.sql.shuffle.partitions", "2"): Define o número de partições após operações de shuffle (comogroupBy). O padrão é 200; reduzir para 2 faz sentido em ambiente local com dados pequenos. .config("spark.driver.memory", "1g"): Memória alocada para o driver (o processo que coordena o trabalho)..getOrCreate(): Cria uma nova sessão ou retorna uma existente.
Exploração inicial
O primeiro contato com os dados envolve métodos básicos mas essenciais:
df_wt.printSchema()          # Mostra a estrutura (schema) do DataFrame
n_linhas = df_wt.count()     # Conta o número de linhas
n_colunas = len(df_wt.columns)  # Conta o número de colunas
O printSchema() revelou que o dataset tem 11 colunas, incluindo date (timestamp), receitas e custos (double), tipos de médico e paciente (string), e os três horários-chave (string, no formato HH:mm:ss).
Limpeza e verificação de duplicatas
duplicadas = n_linhas - df_wt.dropDuplicates().count()
O dropDuplicates() remove linhas idênticas, e a diferença entre a contagem original e a nova revela quantas duplicatas existiam. Neste caso: 0 duplicatas — um dataset limpo.
df_wt.select([F.count(F.when(F.isnan(c) | F.col(c).isNull(), c)).alias(c) for c in df_wt.columns]).show()
Essa expressão usa uma list comprehension para iterar sobre todas as colunas e contar valores nulos (isNull()) ou NaN (isnan()). O resultado mostrou que as colunas de horário (entry_time, post_consultation_time, completion_time) e patient_id têm 13 valores nulos cada — provavelmente registros incompletos.
Valores distintos por coluna
df_wt.select([F.approx_count_distinct(c).alias(c) for c in df_wt.columns]).show()
O approx_count_distinct() é uma função de agregação que estima o número de valores distintos de forma muito mais rápida que o countDistinct() exato — usando o algoritmo HyperLogLog. Em datasets grandes, essa diferença de performance é brutal.
O HyperLogLog é um algoritmo probabilístico usado para estimar o número de elementos únicos (a cardinalidade) em um conjunto de dados muito grande, consumindo uma quantidade mínima de memória.
Renomeando colunas
df_wt = df_wt \
    .withColumnRenamed("Date", "date") \
    .withColumnRenamed("Medication Revenue", "medication_revenue") \
    ...
O withColumnRenamed() é encadeado para converter os nomes originais (com espaços e maiúsculas) para o padrão snake_case, típico de Python. Isso facilita a referência às colunas no código.
Criando métricas de tempo
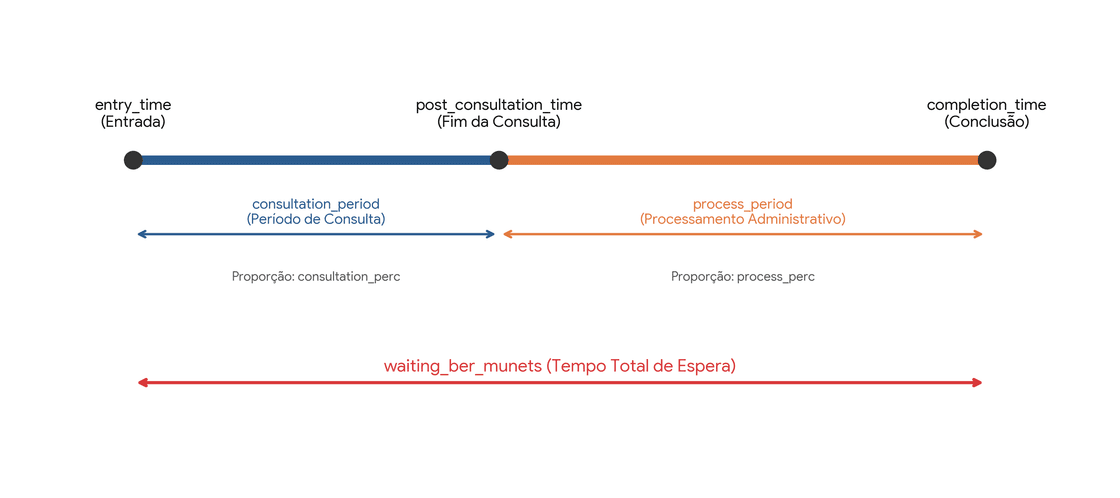
Aqui está a parte mais interessante. O notebook calcula o tempo de espera e outros períodos a partir dos horários de entrada, pós-consulta e conclusão:
entry_time_sec = F.unix_timestamp("entry_time", "HH:mm:ss")
post_consult_sec = F.unix_timestamp("post_consultation_time", "HH:mm:ss")
completion_sec = F.unix_timestamp("completion_time", "HH:mm:ss")
O unix_timestamp() converte strings de horário em segundos desde 1970-01-01. Isso permite fazer aritmética de tempo diretamente.
def _segundos_apos(inicio, fim):
    diferenca = fim - inicio
    return F.when(diferenca < 0, diferenca + 24 * 3600).otherwise(diferenca)
Essa função trata o caso em que o horário final é "menor" que o inicial — o que acontece quando o atendimento atravessa a meia-noite. A solução é somar 24 horas (86.400 segundos) à diferença.
df_wt = (
    df_wt
    .withColumn("waiting_ber_munets", F.round(_segundos_apos(entry_time_sec, completion_sec) / 60))
    .withColumn("consultation_period", F.round(_segundos_apos(entry_time_sec, post_consult_sec) / 60, 2))
    .withColumn("process_period", F.round(_segundos_apos(post_consult_sec, completion_sec) / 60, 2))
    .withColumn("weekday", weekday_map[F.date_format("date", "EEEE")])
    .withColumn("hours", F.hour(F.to_timestamp("entry_time", "HH:mm:ss")))
    .withColumn("consultation_perc", F.round(F.col("consultation_period") / F.col("waiting_ber_munets"), 2))
    .withColumn("process_perc", F.round(1 - F.col("consultation_perc"), 2))
)
Vamos destrinchar:
waiting_ber_munets: tempo total de espera (entrada até conclusão), em minutos. O nome tem um erro de digitação ("ber_munets" em vez de "waiting_minutes"), mas isso não afeta a lógica.consultation_period: tempo da entrada até o fim da consulta (pós-consulta), em minutos.process_period: tempo do fim da consulta até a conclusão (processamento administrativo), em minutos.weekday: dia da semana em português. O notebook usa umcreate_mappara traduzir de inglês para português.hours: hora do dia em que o paciente entrou (0-23).consultation_perc: proporção do tempo total gasta em consulta.process_perc: proporção gasta em processamento.
Agrupamentos e análises
A partir daqui, o notebook usa groupBy para responder às perguntas de negócio:
df_wt.groupBy("date").count().orderBy("date").show()
df_wt.groupBy("doctor_type").count().orderBy(F.desc("count")).show()
df_wt.groupBy("financial_class").count().orderBy(F.desc("count")).show()
O groupBy() agrupa linhas por um ou mais valores, e o count() conta quantas linhas há em cada grupo. O orderBy() ordena o resultado — com F.desc() para ordem decrescente.
Os resultados revelaram, por exemplo, que:
- O dia 11/11/2019 teve o maior número de atendimentos: 3.617
- Médicos do tipo ANCHOR (efetivos) realizaram 21.913 atendimentos, contra 6.789 dos LOCUM (temporários) e 1.296 dos FLOATING (que variam como efetivos e temporários)
- A classe financeira mais comum é INSURANCE (convênio), com 9.931 atendimentos
Filtros com condições
df.where(
    consultation_revenue.isNotNull() & ~F.isnan(consultation_revenue) &
    lab_cost.isNotNull() & ~F.isnan(lab_cost) &
    medication_revenue.isNotNull() & ~F.isnan(medication_revenue)
).orderBy(consultation_revenue.desc()).show(50)
O where() (equivalente a filter()) aplica condições para selecionar apenas as linhas que atendem a todos os critérios. As condições usam & (AND lógico) e ~ (NOT lógico). O resultado mostra os top 50 atendimentos por receita de consulta.
Machine Learning com RandomForestClassifier
O projeto também inclui uma etapa de Machine Learning usando RandomForestClassifier para identificar os fatores que mais influenciam as horas de "alta espera" e estimar quantos médicos adicionais seriam necessários para reduzir a espera em pelo menos 30%. O modelo é treinado com os dados do dataset do Kaggle combinados com uma escala de médicos (escala_medicos.csv) complementar.
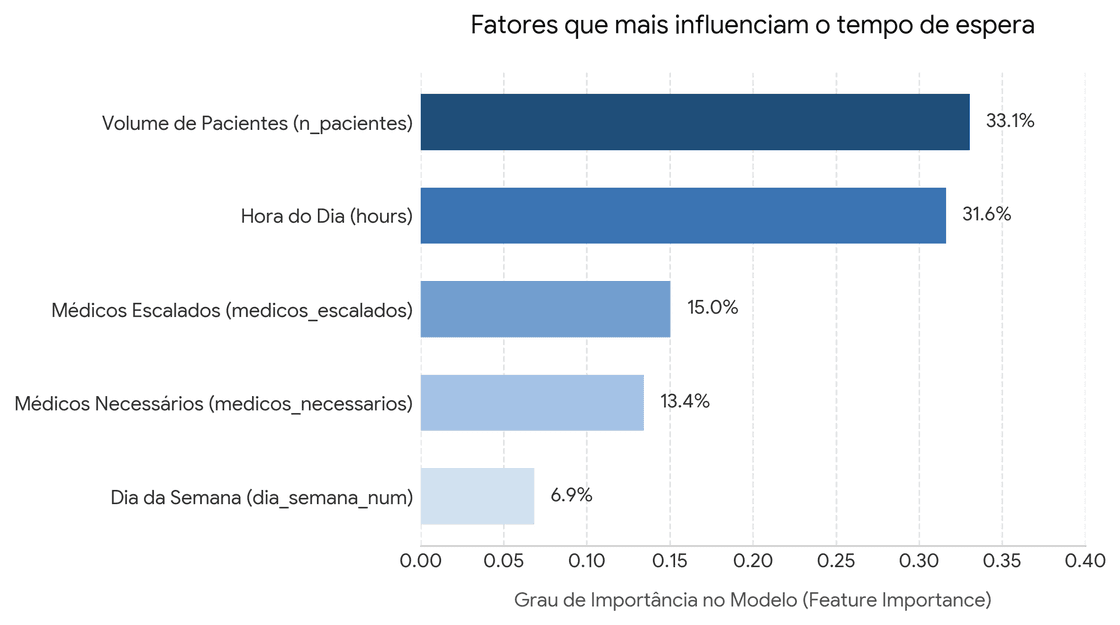
- Gargalo de Volume e Horário: Juntos, o Volume de Pacientes (33,1%) e a Hora do Dia (31,6%) acumulam quase 65% do peso de decisão do algoritmo para determinar janelas de alta espera. Isso valida estatisticamente a necessidade de dimensionar escalas dinâmicas de acordo com curvas de demanda horária.
- Ajuste Proposto: O cálculo complementar indica que o hospital opera em déficit em 68% das janelas observadas (140 de 206 horas analíticas), exigindo um reforço imediato de 22 médicos adicionais alocados estrategicamente nos momentos críticos para atingir a meta de redução de (30%) nas filas.
Funções e métodos PySpark usados
A tabela abaixo consolida todas as funções e métodos PySpark utilizados no notebook, com uma descrição técnica e um exemplo de aplicação
| Função / Método | Módulo / Classe | Descrição | Exemplo no notebook |
|---|---|---|---|
SparkSession.builder | pyspark.sql | Construtor para criar/configurar uma SparkSession | SparkSession.builder.master("local") |
.master("local") | SparkSession builder | Define o modo de execução (local, yarn, spark://) | .master("local") |
.appName("...") | SparkSession builder | Define o nome da aplicação | .appName("atendimento-hospitalar") |
.config(chave, valor) | SparkSession builder | Define configurações da sessão | .config("spark.sql.shuffle.partitions", "2") |
.getOrCreate() | SparkSession builder | Cria ou retorna a SparkSession existente | .getOrCreate() |
spark.version | SparkSession | Retorna a versão do Spark | print(spark.version) |
df.printSchema() | DataFrame | Exibe a estrutura (schema) do DataFrame: colunas, tipos e nulabilidade | df_wt.printSchema() |
df.count() | DataFrame | Conta o número de linhas | n_linhas = df_wt.count() |
len(df.columns) | DataFrame (atributo) | Lista o nome das colunas; len() conta quantas são | len(df_wt.columns) |
df.dropDuplicates() | DataFrame | Remove linhas duplicadas | df_wt.dropDuplicates().count() |
df.select() | DataFrame | Seleciona colunas ou expressões | df_wt.select("patient_id", "weekday").show(5) |
df.show(n) | DataFrame | Exibe as primeiras n linhas | df_wt.show(2) |
df.withColumnRenamed(antigo, novo) | DataFrame | Renomeia uma coluna | .withColumnRenamed("Date", "date") |
df.withColumn(nome, expressão) | DataFrame | Cria ou substitui uma coluna | .withColumn("weekday", weekday_map[...]) |
df.where(condição) | DataFrame | Filtra linhas por condição | df.where(F.col("lab_cost") > 100) |
df.groupBy(colunas) | DataFrame | Agrupa por uma ou mais colunas | df_wt.groupBy("doctor_type") |
df.orderBy(colunas) | DataFrame | Ordena o resultado | .orderBy("date") |
df.isNotNull() | Column | Verifica se o valor não é nulo | F.col("x").isNotNull() |
F.col(nome) | pyspark.sql.functions | Referencia uma coluna | F.col("Consultation Revenue") |
F.isnan(coluna) | functions | Verifica se o valor é NaN | ~F.isnan(consultation_revenue) |
F.count(coluna) | functions | Conta valores não nulos | F.count(F.when(...)) |
F.when(condição, valor) | functions | Expressão condicional (tipo um "if" SQL) | F.when(diferenca < 0, ...) |
F.round(coluna, n) | functions | Arredonda para n casas decimais | F.round(valor / 60, 2) |
F.desc(coluna) | functions | Ordem decrescente | F.desc("count") |
F.lit(valor) | functions | Cria uma coluna literal | F.lit(x) |
F.unix_timestamp(coluna, formato) | functions | Converte string de data/hora em timestamp Unix | F.unix_timestamp("entry_time", "HH:mm:ss") |
F.to_timestamp(coluna, formato) | functions | Converte string em timestamp | F.to_timestamp("entry_time", "HH:mm:ss") |
F.hour(coluna) | functions | Extrai a hora de um timestamp | F.hour(F.to_timestamp(...)) |
F.date_format(coluna, formato) | functions | Formata data/hora como string | F.date_format("date", "EEEE") |
F.create_map(pares) | functions | Cria um mapa (dicionário) como coluna | F.create_map([F.lit(x) for pair in ...]) |
F.approx_count_distinct(coluna) | functions | Estimativa rápida de valores distintos | F.approx_count_distinct(c) |
F.rand(seed) | functions | Gera número aleatório | (usado na etapa de ML) |
Aplicabilidade real: o que isso resolve?
Cenário atual: filas que custam caro
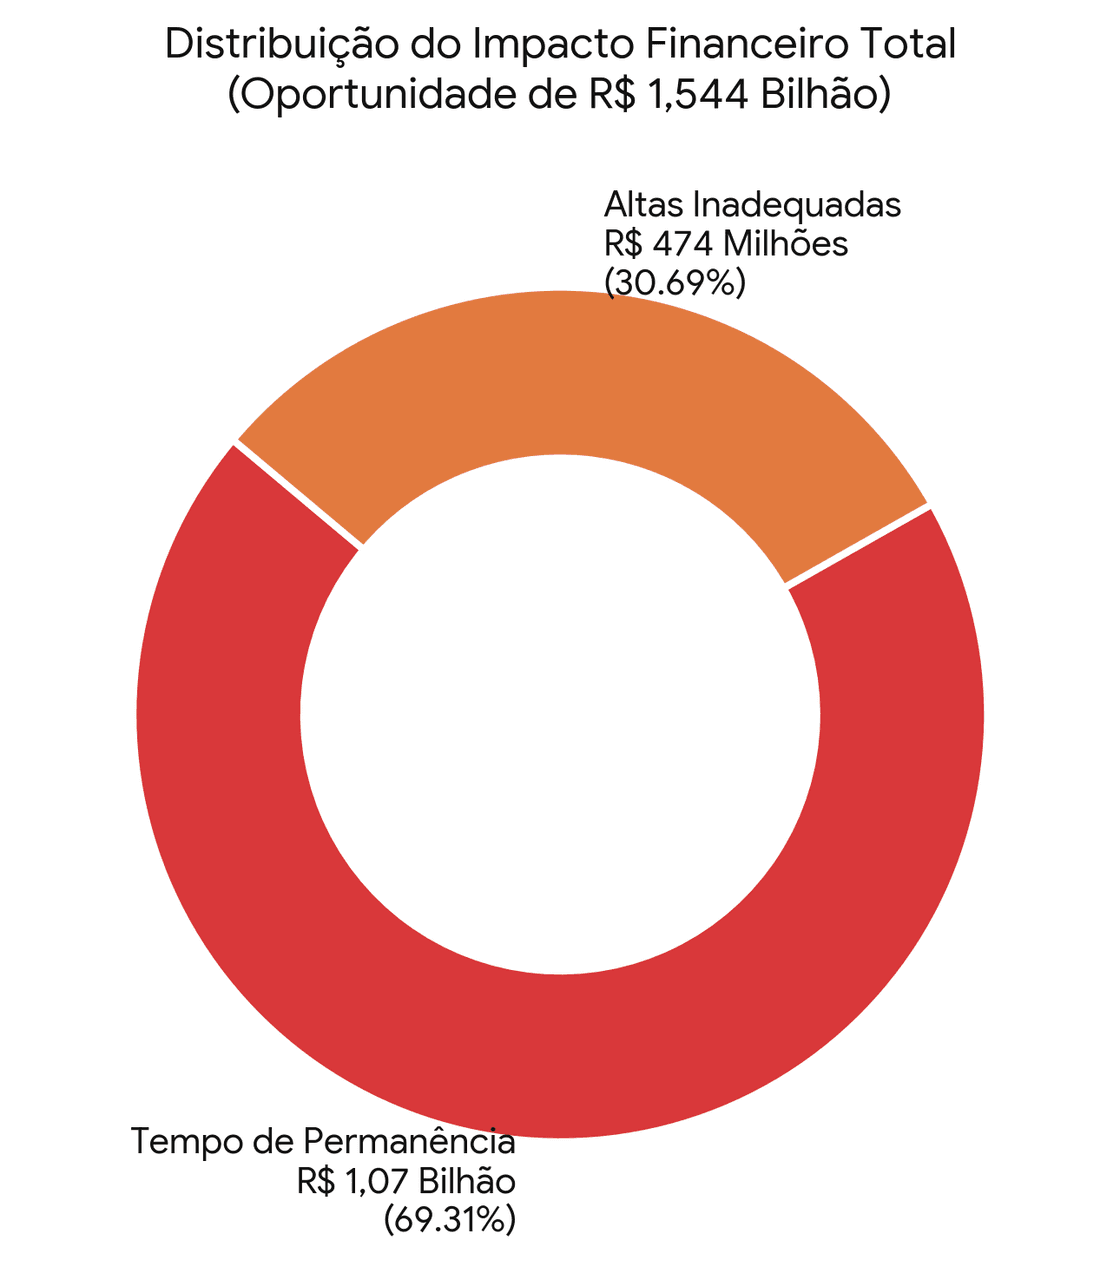
Voltemos aos dados. Um estudo da 2iM analisou quase 104 mil internações em sete hospitais de grande porte e identificou que o tempo de permanência hospitalar é o principal vetor de perda financeira: cada dia extra de internação impacta diretamente a rotatividade de leitos e a capacidade de geração de receita. Cerca de 30,69% das altas ocorreram fora do horário considerado adequado, gerando um impacto adicional estimado em R$ 474 milhões.
Detalhamento das Perdas Financeiras
- Tempo de Permanência Excedente (69,31%): Representa o maior gargalo operacional do estudo, gerando um prejuízo estimado em R$ 1,07 bilhão decorrente da retenção indevida de leitos.
- Altas fora do Horário Adequado (30,69%): Corresponde a R$ 474 milhões em desperdícios operacionais causados pela falta de sincronia na liberação dos pacientes, atrasando novas admissões no mesmo dia.
Como o projeto se aplica na prática
Imagine que você é gestor de um hospital e recebe reclamações constantes sobre o tempo de espera. Com a abordagem do projeto, você poderia:
- Coletar dados de atendimento (horários de entrada, consulta e conclusão) do seu sistema de gestão.
- Carregar no PySpark — especialmente se o volume de dados for grande (milhões de registros ao longo de anos).
- Calcular os mesmos indicadores: tempo total de espera, período de consulta, período de processamento, distribuição por dia da semana e hora do dia.
- Identificar padrões: os horários de pico, os dias mais críticos, os tipos de paciente que mais esperam.
- Tomar decisões baseadas em dados: escalar mais médicos nos horários de pico, reorganizar o fluxo de processamento administrativo, criar filas preferenciais para determinados perfis.
O caso do boarding na emergência
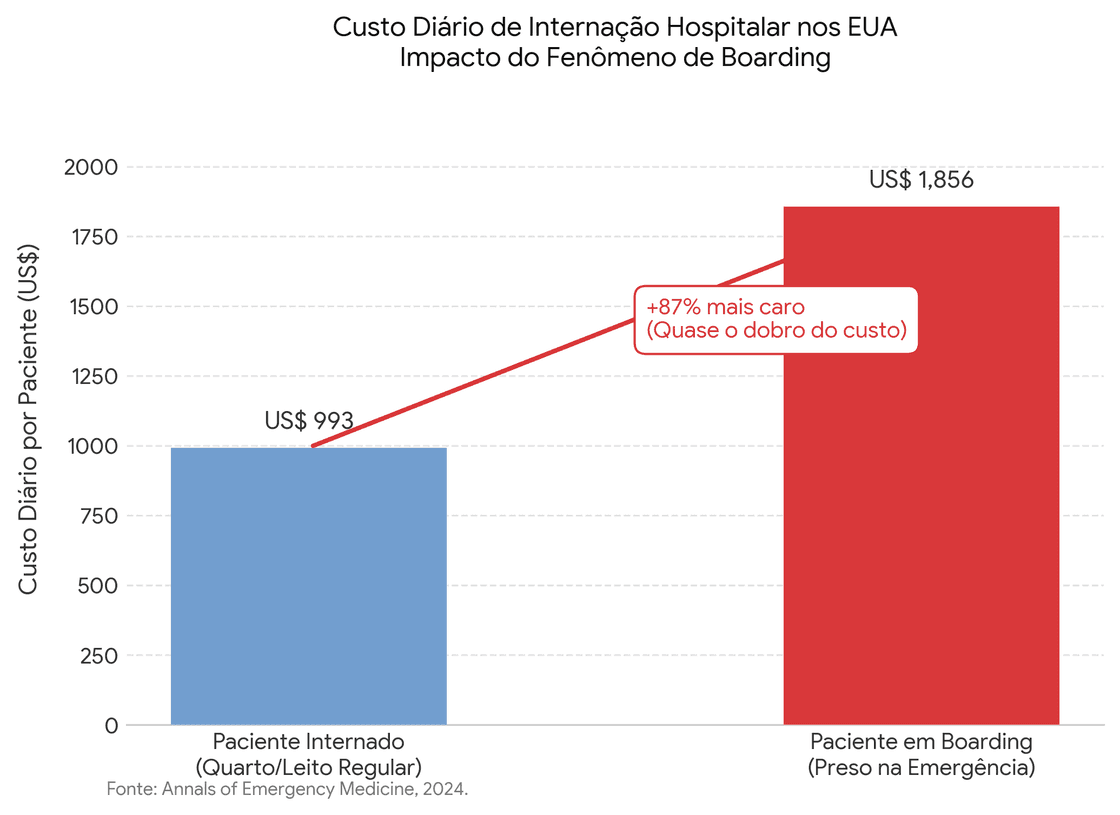
Nos Estados Unidos, o boarding — quando um paciente já admitido fica "preso" na emergência esperando por um leito de internação — virou uma crise de saúde pública. Um estudo mostrou que o custo diário por paciente em boarding é de U 993 para pacientes já internados.
E não para por aí: o mesmo estudo aponta que o boarding está associado a desvios de ambulância, erros médicos evitáveis, episódios de violência e burnout das equipes de cuidado.
Análise Comparativa do Impacto Financeiro
- Gargalo na Emergência (Boarding): Manter um paciente estabilizado retido na emergência por falta de leito custa US$ 1.856 diários, onerando drasticamente o hospital devido ao consumo de recursos críticos do pronto-socorro.
- Eficiência de Leito Regular: O fluxo normal de internação registra um custo operacional significativamente menor de US$ 993 diários, liberando espaço físico para que novos casos urgentes entrem nas salas de trauma e triagem sem interrupções.
Lições do notebook para o mundo real
O notebook do projeto, embora seja um estudo, demonstra uma metodologia que pode ser diretamente adaptada para ambientes de produção. A combinação de análise exploratória com PySpark e Machine Learning com RandomForest permite não só diagnosticar o problema, mas também simular cenários: "Se eu adicionar X médicos no horário Y, qual será a redução esperada no tempo de espera? Qual o impacto na receita?"
Essa é a diferença entre gerir por intuição e gerir por dados. E no setor hospitalar, onde cada minuto de espera pode significar vidas e milhões, essa diferença é crucial.
Contudo, não estou querendo dizer que se trata simplesmente de obter dados e aplicar na vida real. Gerir um hospital deve envolver centenas de outras variáveis que não capaz de incluir aqui, como o valor de plantão dos médicos e etc. Não é uma tarefa simples, mas o objetivo aqui é simplesmente o estudo do PySpark.
Conclusão
O projeto atendimento-hospitalar-pyspark é um excelente ponto de partida para quem quer aprender PySpark aplicado a dados reais de saúde. Ele cobre desde a configuração do ambiente (que, convenhamos, é a parte mais chata) até análise exploratória e Machine Learning.
Mais do que isso, ele nos lembra de uma verdade incômoda: as filas nos hospitais não são apenas um problema de saúde pública — são um problema de gestão de dados. O tempo de espera que o paciente sente na pele é o mesmo tempo que aparece como custo extra no balanço do hospital e como receita não realizada no final do mês.
Se você trabalha com dados na área da saúde — ou quer trabalhar — vale a pena clonar o repositório, rodar o notebook e explorar os dados por conta própria. O código está aberto, documentado e pronto para ser adaptado à sua realidade.
Referências
- Repositório do projeto: atendimento-hospitalar-pyspark
- Dataset: Hospital Patient Data — Kaggle
- Estudo 2iM/JBES: "Ineficiência hospitalar pode gerar perdas de R$ 2 bi" — Healthcare Management
- Annals of Emergency Medicine: "Boarding Patients in Emergency Departments Nearly Doubles Daily Cost of Care" — ACEP
- O Globo / Câmara dos Deputados: "Tempo médio de espera para consultas no SUS atinge recorde histórico" — Requerimento de Informação nº 871/2025
- Instituto Oncoguia: "Entre a fila do SUS e a vida: prazo para cirurgia mantém patamar recorde pós-pandemia"
Fique ligado
Seja um Expert em Growth
Receba insights práticos sobre marketing, dados, performance e tecnologia direto no seu email.